발행일: 2026.10.21 09:23 KST
이 글은 발행 시점에 확인 가능한 공개 자료를 기준으로 작성했습니다.
발행일: 2026년 10월 21일
핵심 요약
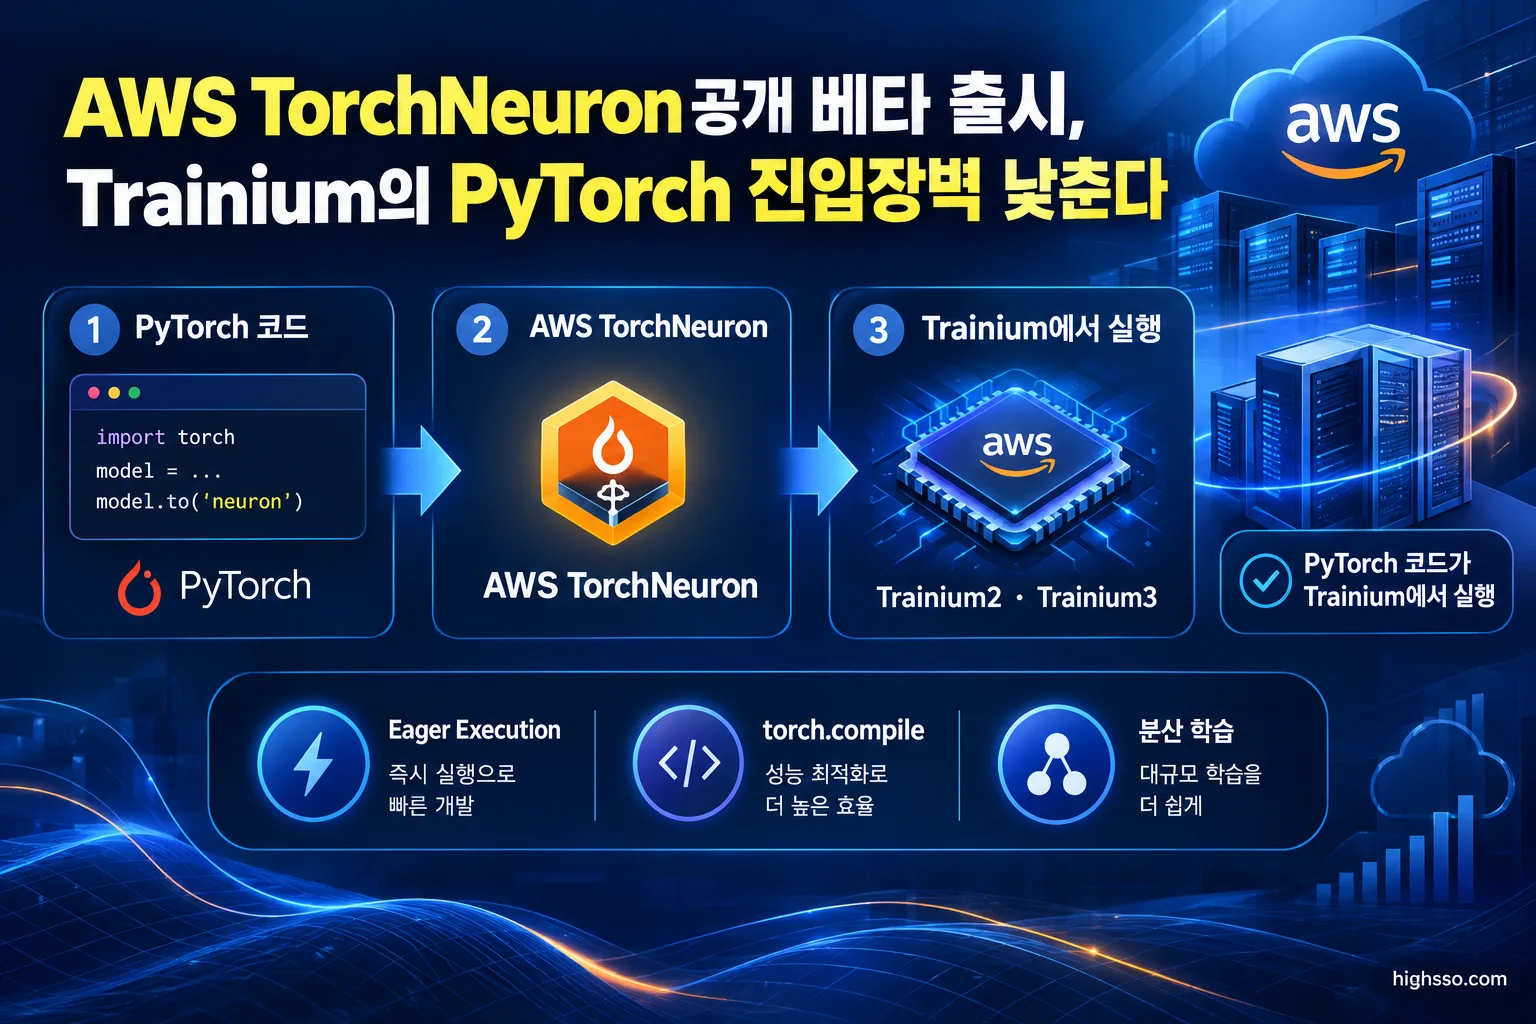
- AWS는 2026년 10월 20일 Trainium2와 Trainium3용 오픈소스 네이티브 PyTorch 백엔드 AWS TorchNeuron 공개 베타를 출시했습니다.
- Hugging Face 기준으로 상위 100개 텍스트 생성 모델 아키텍처의 89%를 기본 지원합니다. 기존 Optimum Neuron v0.4.5의 동일 기준 지원률은 46%였습니다.
- AWS는 TorchNeuron을 통해 별도의 Neuron 전용 모델 클래스나 트레이너 없이 기존 PyTorch·Hugging Face 개발 흐름에서 Trainium을 사용할 수 있도록 하는 방향을 제시했습니다.
- 이번 발표는 Trainium 하드웨어 자체보다 Nvidia CUDA 중심 생태계와의 소프트웨어 전환 비용을 낮추려는 AWS의 전략에 의미가 있습니다. 다만 공개 베타인 만큼 CUDA를 단기간에 대체한다고 보기는 어렵습니다.
무슨 일이 있었나
AWS는 Trainium용 네이티브 PyTorch 백엔드인 AWS TorchNeuron을 공개 베타로 내놓았습니다. 개발자는 PyTorch 표준 확장 메커니즘을 통해 neuron 디바이스를 추가하고, 모델과 입력을 .to('neuron')으로 이동해 Trainium에서 실행할 수 있습니다.
지원 대상은 Amazon EC2 Trainium2와 Trainium3 인스턴스입니다. AWS가 제시한 기능에는 PyTorch의 eager execution, torch.compile, 표준 PyTorch API, 분산 학습 기능이 포함됩니다. TorchNeuron은 Trainium 전용 최적화를 위해 Neuron Kernel Interface와도 연동됩니다.
Hugging Face는 Transformers, Diffusers, Accelerate, PEFT, TRL에서 TorchNeuron을 직접 지원한다고 밝혔습니다. 이는 기존처럼 Neuron 전용 모델 클래스나 트레이너를 별도로 사용하는 방식보다 일반적인 PyTorch 및 Hugging Face 인터페이스에 가까운 접근입니다.
다만 ‘기존 코드를 그대로 실행할 수 있다’는 표현을 모든 PyTorch 프로그램이 수정 없이 즉시 작동한다는 뜻으로 해석해서는 안 됩니다. AWS Neuron의 호환성 가이드에 따르면 PyTorch API는 지원, CPU 폴백, 미지원 영역으로 구분됩니다. 또한 현재 torch.compile에서는 동적 shape와 symbolic integer가 지원되지 않으며 dynamic=False가 요구됩니다.
핵심 숫자
| 항목 | 확인된 수치 또는 내용 |
|---|---|
| 공개 베타 출시일 | 2026년 10월 20일 |
| 지원 하드웨어 | Trainium2, Trainium3 |
| 상위 100개 텍스트 생성 모델 아키텍처 기본 지원률 | 89% |
| Optimum Neuron v0.4.5 지원률 | 46% |
| Reuters가 보도한 초기 고객 | 30곳 초과 |
| Trainium·Graviton 합산 연간 매출 런레이트 | 100억 달러 초과 |
| Trainium2 도입 칩 수 | 140만 개 |
| Project Rainier의 Trainium2 규모 | 50만 개 초과 |
| 오픈소스 라이선스 | Apache 2.0 |
Amazon 공식 IR 자료에 따르면 Trainium과 Graviton을 합산한 연간 매출 런레이트는 100억 달러를 넘어섰습니다. 또한 Trainium2는 완전 예약 상태이며, Trainium3도 2026년 중반까지 공급 물량 대부분이 약정될 것으로 제시됐습니다.
이 수치는 TorchNeuron 출시 이전부터 AWS 자체 칩 수요가 존재했다는 점을 보여줍니다. 따라서 이번 소프트웨어 발표는 새로운 수요를 처음 만들어내는 사건이라기보다, 이미 형성된 Trainium 수요를 더 많은 개발자와 워크로드로 확장하려는 조치에 가깝습니다.
왜 중요한가
AWS: 하드웨어보다 포팅 비용을 낮추는 전략
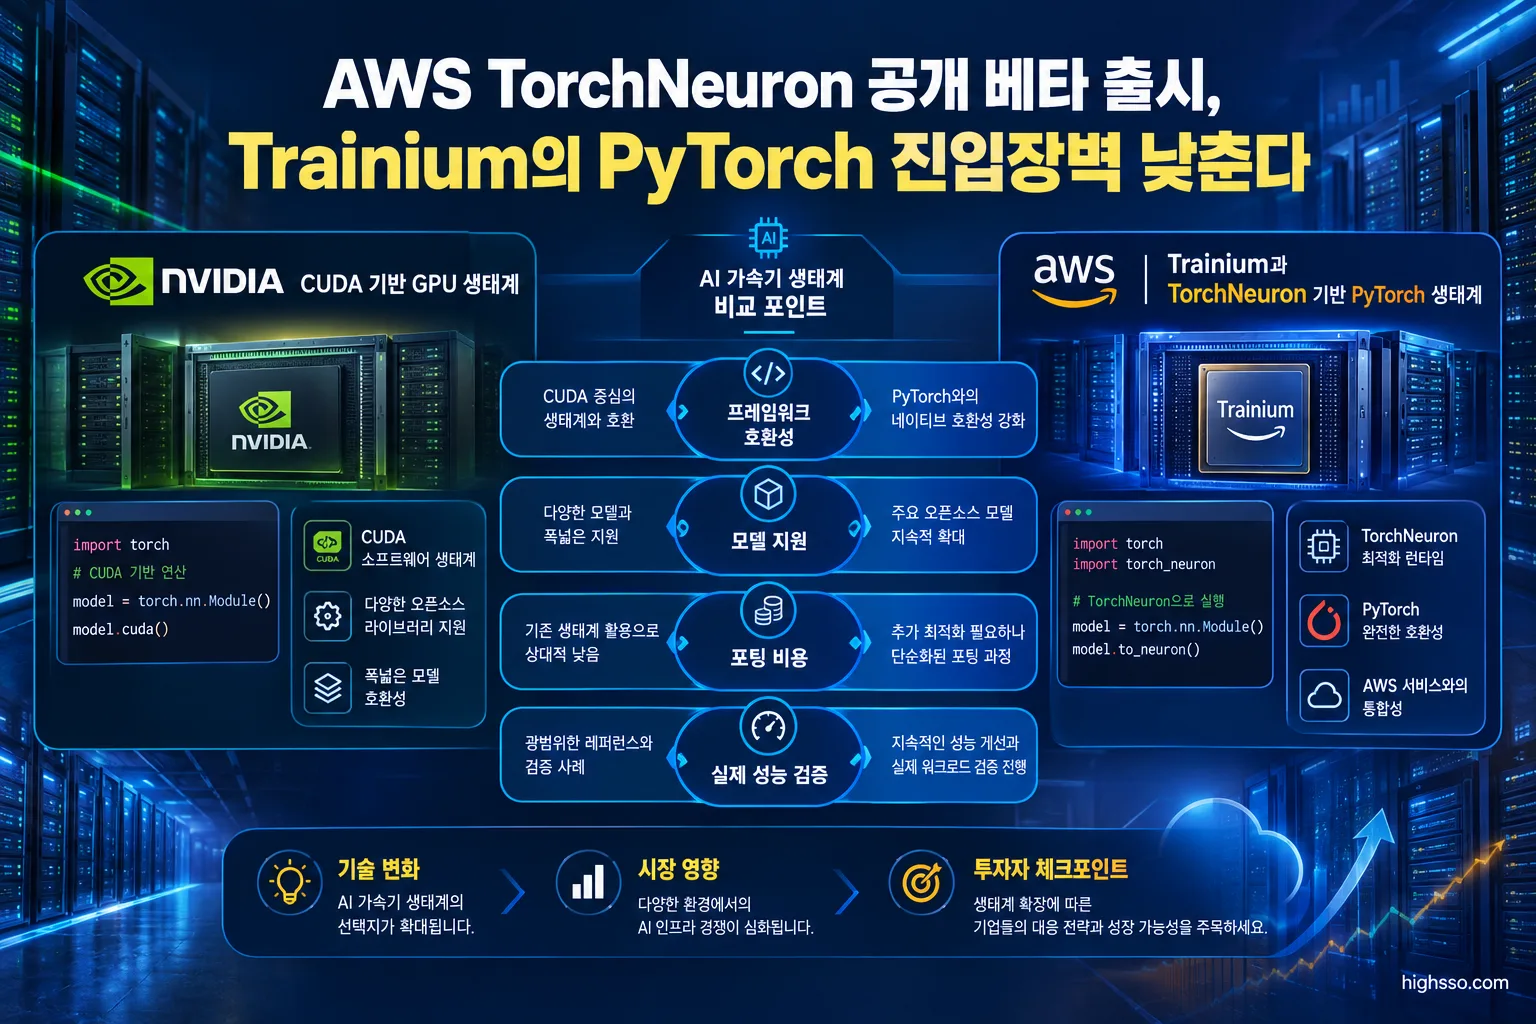
AI 가속기 선택에서 성능과 가격만큼 중요한 요소가 소프트웨어 호환성입니다. 개발자가 Nvidia GPU와 CUDA에 맞춰 작성한 모델과 학습 코드를 다른 하드웨어로 옮기려면 API 수정, 연산자 재작성, 성능 검증이 필요할 수 있습니다. 이 과정에서 발생하는 시간과 인력 비용은 특정 가속기 생태계에 대한 높은 전환 장벽으로 작용합니다.
AWS TorchNeuron은 표준 PyTorch와 Hugging Face 인터페이스를 활용해 이 장벽을 낮추려는 도구입니다. 개발자가 기존 프레임워크를 유지하면서 Trainium을 시험할 수 있다면, AWS는 자체 AI 칩을 클라우드 서비스의 대안으로 제시하기 쉬워집니다.
이는 AWS가 Nvidia GPU 의존도를 낮추고 AI 인프라 비용 구조를 개선하려는 전략과 연결될 수 있습니다. 다만 실제 효과는 지원되는 모델 수가 아니라 고객의 실제 이전 규모, 학습·추론 성능, 운영 안정성, 비용 절감으로 판단해야 합니다.
Hugging Face 지원 범위 확대의 의미
상위 100개 텍스트 생성 모델 아키텍처 중 89%를 기본 지원한다는 수치는 개발자 접근성을 높이는 요소입니다. 기존 Optimum Neuron v0.4.5의 46%와 비교하면 지원 범위가 확대됐습니다.
다만 이 수치는 아키텍처 기준 지원률이며, 모든 모델의 최적 성능이나 모든 연산의 완전한 호환성을 의미하지는 않습니다. 실제 워크로드에서는 모델별 연산자 지원 여부, 컴파일 성공 여부, 동적 입력 처리, 분산 학습 성능을 별도로 확인해야 합니다.
Nvidia에 대한 의미
Nvidia 입장에서는 이번 발표가 CUDA 자체를 즉시 대체하는 사건이라기보다, 개발자가 하드웨어를 선택할 때 부담하는 포팅 비용과 생태계 잠금 효과를 약화시키려는 경쟁으로 볼 수 있습니다.
Google TPU와 AMD GPU 등도 PyTorch 호환성 강화를 추진하고 있습니다. 이에 따라 AI 가속기 시장의 경쟁 기준은 칩의 연산 성능뿐 아니라 프레임워크 호환성, 개발자 경험, 모델 지원 범위, 클라우드에서의 실제 비용으로 넓어질 가능성이 있습니다.
관련 산업·종목
Amazon(AMZN)
AMZN에는 AWS 자체 AI 칩 사용 확대와 클라우드 인프라 차별화라는 연결고리가 있습니다. TorchNeuron은 Trainium을 직접 판매하는 제품이라기보다 고객이 Trainium을 시험하고 실제 워크로드를 이전하도록 돕는 소프트웨어 유입 경로에 가깝습니다.
따라서 단기적으로 소프트웨어 매출을 따로 평가하기보다는 AWS AI 인프라 수요, Trainium 공급량, 고객 유지율, 클라우드 원가 및 영업이익률에 어떤 변화가 나타나는지 확인할 필요가 있습니다.
Nvidia(NVDA)
NVDA에는 중장기적으로 잠재적인 경쟁 압력이 될 수 있습니다. 개발자가 기존 PyTorch 코드를 활용해 다른 가속기로 이동하기 쉬워지면, CUDA 생태계의 전환 장벽이 일부 낮아질 수 있기 때문입니다.
그러나 TorchNeuron은 공개 베타 단계이고 동적 shape와 일부 API에 제약이 있습니다. 따라서 현재 공개 자료만으로 Nvidia GPU와 CUDA 생태계의 즉각적인 약화를 단정하기는 어렵습니다.
서버·네트워크·메모리 공급망
Trainium 사용이 확대되면 장기적으로 AI 서버, 네트워크, HBM·메모리, 패키징 등 관련 공급망의 수요 구조에도 영향을 줄 수 있습니다. 다만 이번 발표에서는 특정 한국 기업의 수주나 공급 규모가 공개되지 않았습니다. 따라서 국내 관련 종목의 직접 수혜를 이번 뉴스만으로 단정해서는 안 됩니다.
투자자가 볼 핵심
- 소프트웨어 지원률과 실제 성능은 구분해야 합니다. 89%라는 아키텍처 지원률이 실제 고객 워크로드의 성공률이나 Nvidia 대비 비용·성능을 의미하지는 않습니다.
- 공개 베타가 실제 고객 이전으로 이어지는지 확인해야 합니다. 초기 고객이 30곳을 넘는다는 보도와 실제 대규모 상용 배포는 다른 단계입니다.
- Trainium 수요가 AWS 실적 지표로 연결되는지 봐야 합니다. Trainium·Graviton 매출 런레이트와 예약률이 실제 AWS 매출 성장 및 마진 개선으로 이어지는지가 중요합니다.
- CUDA 대체 여부보다 선택지 확대를 먼저 봐야 합니다. 현재로서는 Nvidia 생태계를 단기간에 대체하기보다 AWS가 개발자와 고객에게 추가적인 가속기 선택지를 제공하는 단계로 해석하는 편이 합리적입니다.
앞으로 확인할 것
- TorchNeuron이 공개 베타에서 일반 제공 버전으로 전환되는 시점과 정식 지원 범위
- 지원 모델 아키텍처와 PyTorch API가 추가로 확대되는지 여부
- 동적 shape, symbolic integer 등 현재 제약 사항의 해소 여부
- Trainium2·Trainium3의 실제 공급량과 대형 고객의 사용 규모
- AWS AI 인프라 매출, 원가, 영업이익률에 나타나는 변화
이번 AWS TorchNeuron 출시는 Trainium의 하드웨어 성능을 새로 발표한 뉴스라기보다, 개발자가 AWS 자체 칩으로 이동할 때 부담하는 소프트웨어 비용을 낮추려는 움직임입니다. 실제 산업 영향은 베타 출시 자체보다 고객의 반복 사용, 모델 지원 확대, 비용·성능 검증이 얼마나 빠르게 진행되는지에 따라 결정될 가능성이 큽니다.
출처 및 참고자료
이 글은 아래 공식 자료와 주요 보도를 바탕으로 작성했습니다.
- Amazon Web Services — AWS announces TorchNeuron: Native PyTorch Support for AWS Trainium (Public Beta)
- Hugging Face — TorchNeuron: running HF models on AWS Trainium is easier than ever
- AWS Neuron GitHub — torch-neuronx: A native PyTorch backend for AWS Trainium
- Amazon — Amazon's TorchNeuron runs PyTorch on AWS Trainium chips
- Amazon Investor Relations — Amazon.com Announces Fourth Quarter Results
- Reuters — Amazon says its AI chips will work with popular coding language, challenging Nvidia
- PyTorch — Introducing TorchNeuron: Native PyTorch backend for AWS Trainium
투자 유의사항
본 콘텐츠는 공개 자료를 바탕으로 작성한 정보 제공 목적의 글이며, 특정 종목의 매수·매도 추천이나 투자 자문이 아닙니다. 투자 판단과 책임은 본인에게 있으며, 실제 투자 전에는 공시, 기업 실적 및 시장 상황을 추가로 확인하시기 바랍니다.