발행일: 2026.10.14 09:23 KST
이 글은 발행 시점에 확인 가능한 공개 자료를 기준으로 작성했습니다.
발행일: 2026년 10월 14일
핵심 요약
- Nvidia 고객사 자체 AI 칩 개발이 내부 실험을 넘어 대규모 데이터센터 배치와 클라우드 서비스 통합 단계로 확대되고 있습니다.
- Microsoft는 2027년부터 Azure Maia 제품군을 멀티기가와트 규모로 확대하고, Maia를 자사 제품과 서비스의 주력 추론 시스템으로 활용할 계획이라고 밝혔습니다.
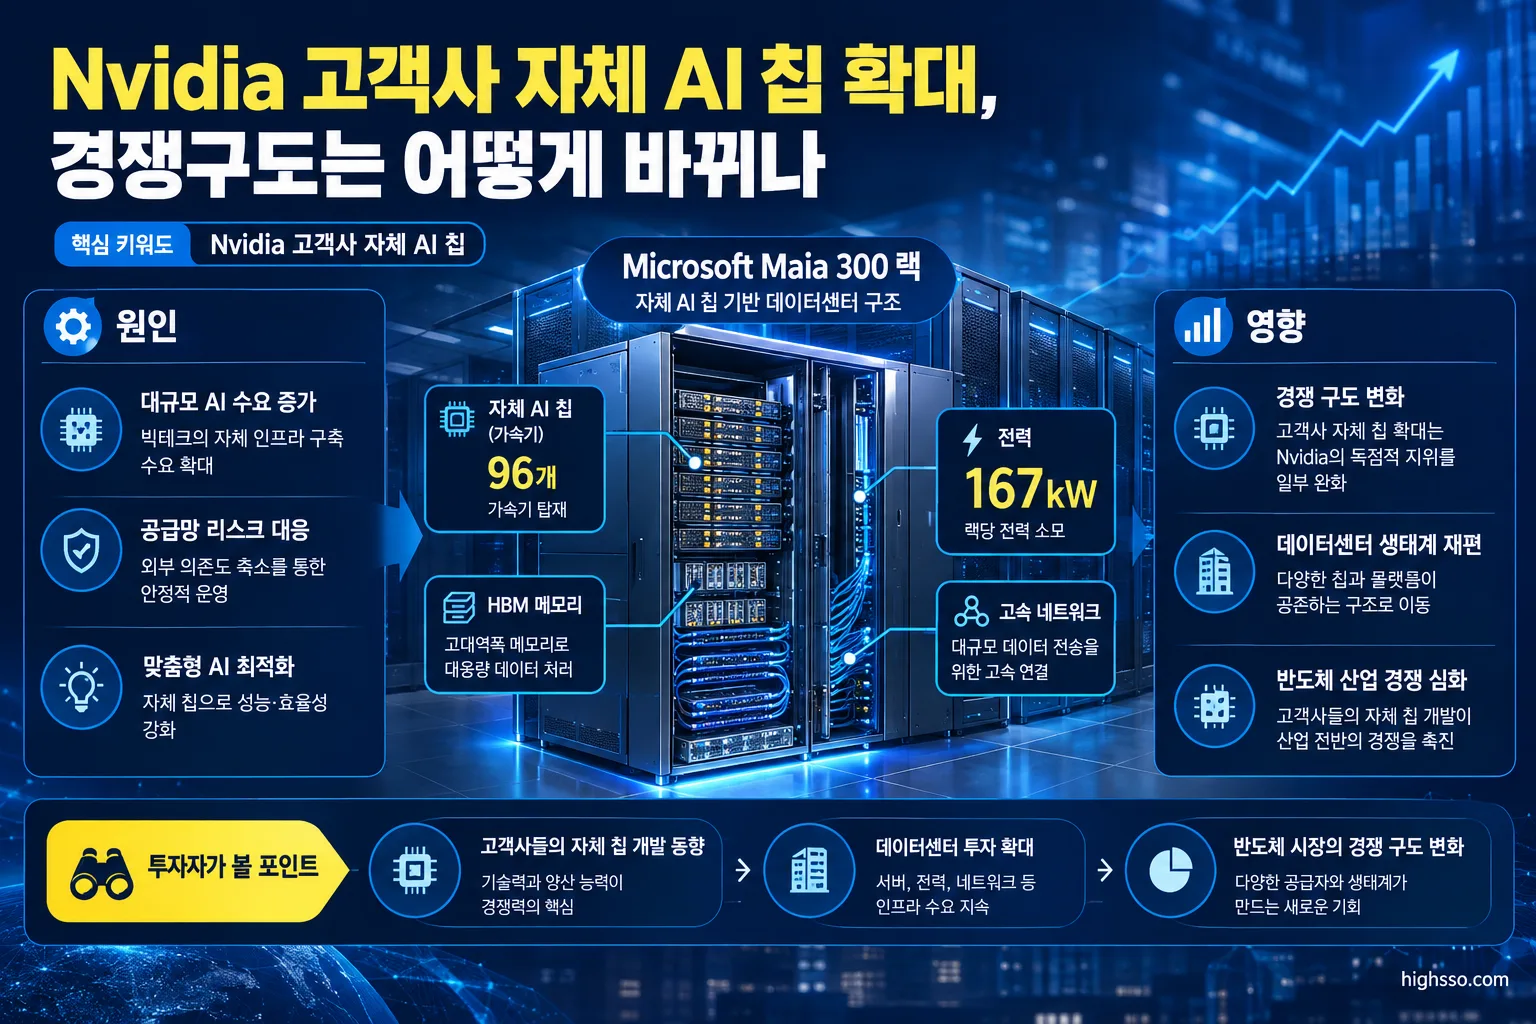
- Microsoft Maia 300 랙은 가속기 96개, 167kW 전력, 27.6TB HBM, 1.7PB/s HBM 대역폭을 제공합니다. Reuters는 2027년 Maia 300의 잠재 배치 규모가 100만 개를 넘을 수 있다고 보도했지만, 이는 확정 출하량이 아닙니다.
- 현재 확인되는 변화는 Nvidia GPU의 즉각적인 퇴출보다, 대형 고객이 Nvidia·AMD·자체 ASIC을 함께 사용하는 이기종 AI 인프라 전략을 강화하는 흐름에 가깝습니다.
무슨 일이 있었나
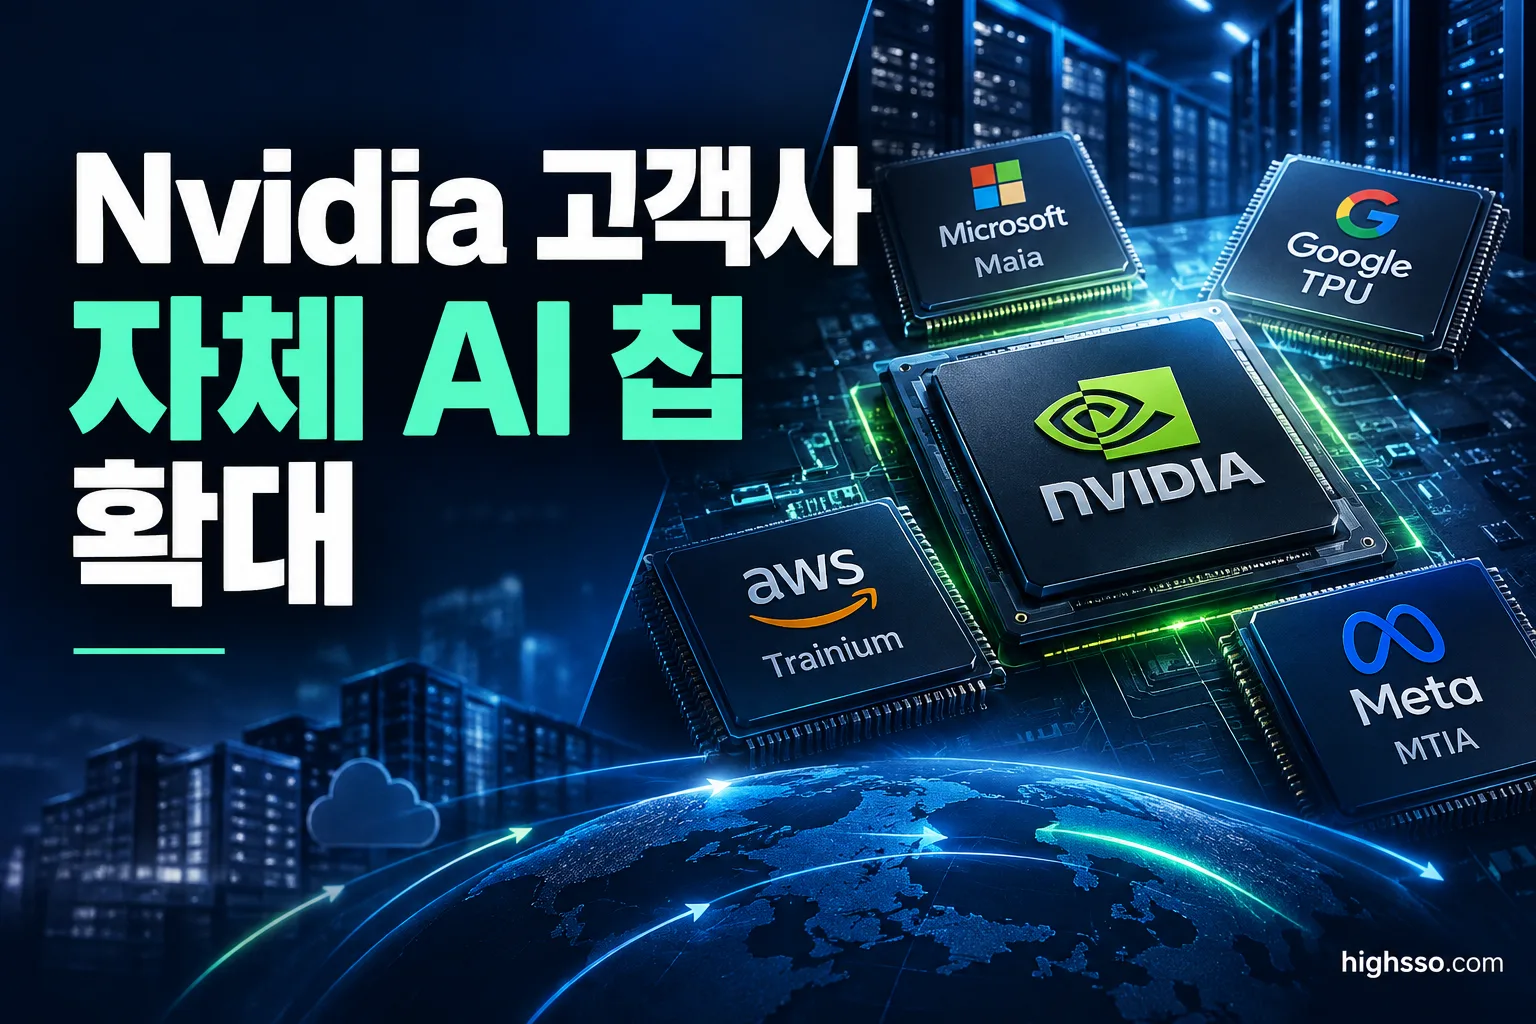
Microsoft, Google, Amazon Web Services, Meta가 자체 설계 AI 가속기의 개발과 배치를 동시에 확대하고 있습니다. 공통점은 자체 칩을 단순한 연구 프로젝트로 두지 않고, 자사 클라우드와 광고·추천·생성형 AI 서비스에 연결하고 있다는 점입니다.
Microsoft는 2026년 10월 12일 공식 블로그에서 2027년부터 Azure Maia를 멀티기가와트 규모로 배치하고, Maia를 Microsoft 제품과 서비스의 주력 추론 시스템으로 활용하겠다고 밝혔습니다. Maia 200은 이미 Microsoft Copilot 등 실제 생산 워크로드에 투입됐으며, GitHub Copilot과 Microsoft Foundry로 적용 범위를 확대할 계획입니다.
Reuters는 Microsoft가 2027년에 Maia 300을 잠재적으로 100만 개 이상 배치할 계획이라고 보도했습니다. 다만 이는 Microsoft가 공식적으로 확정한 구매·출하 수량이 아니라 Reuters가 전한 잠재적 배치 계획으로 구분해야 합니다.
Google은 Gemini, Veo, Imagen, Anthropic의 Claude 등 주요 AI 모델의 학습과 추론에 자체 TPU를 활용하고 있습니다. AWS는 Trainium·Inferentia를 AWS 클라우드 상품과 Neuron 소프트웨어 생태계에 통합하고 있으며, Meta는 향후 2년 동안 MTIA 커스텀 칩 4세대를 개발·배치하겠다고 밝혔습니다.
핵심 숫자
| 항목 | 확인된 내용 | 의미 |
|---|---|---|
| Microsoft Maia 300 랙 | 가속기 96개 | 랙 단위 AI 추론 시스템 |
| Maia 300 랙 전력 | 167kW | 데이터센터 전력·냉각 설계와 연결 |
| Maia 300 랙 HBM | 27.6TB | 대규모 모델 추론을 위한 메모리 용량 |
| Maia 300 랙 HBM 대역폭 | 1.7PB/s | 랙 전체 메모리 처리 성능 |
| Microsoft Maia 확대 | 2027년부터 멀티기가와트 규모 | 자체 칩의 대규모 배치 계획 |
| Maia 300 잠재 배치 | 100만 개 이상 | Reuters 보도 기준 잠재 규모이며 확정 출하량은 아님 |
| Microsoft Maia 200 비용 개선 | 자사 최신 인프라 대비 토큰당 30% 이상 | Microsoft가 제시한 자체 비교 수치 |
| Google Ironwood TPU 구성 | 최대 9,216개 칩 | 포드 단위 대규모 AI 연산 시스템 |
| AWS Trainium3 | FP8 2.52PFLOPS, HBM3e 144GB | AWS가 공개한 칩 사양 |
| Trn3 UltraServer | 최대 144개 Trainium3 칩 | 서버 단위 확장 구조 |
| Meta MTIA 배치 | 현재 수십만 개 | 콘텐츠·광고 추천 추론에 활용 |
| Meta·Broadcom 초기 배치 | 1GW 초과 | 커스텀 칩에서 랙·시스템 단위로 확대 |
Microsoft와 Google이 제시한 성능·효율 수치는 각 회사가 공개한 자체 비교 결과입니다. 독립적인 공통 벤치마크와는 구분할 필요가 있습니다.
왜 중요한가
범용 GPU 중심에서 워크로드별 가속기로 이동
대형 클라우드 사업자는 자사 서비스의 모델과 사용 패턴을 비교적 구체적으로 파악할 수 있습니다. Copilot, Gemini, 광고 추천, 검색, 클라우드 추론처럼 반복적으로 발생하는 작업은 특정 모델과 소프트웨어에 맞춰 연산·메모리·네트워크를 함께 최적화하기 쉽습니다.
이런 구조에서는 자체 ASIC이 성능뿐 아니라 토큰당 비용, 전력 효율, 공급 안정성 측면에서 의미를 가질 수 있습니다. Microsoft가 Maia 200의 토큰당 비용 개선을 강조한 것도 이러한 경제성을 보여주려는 발표로 해석할 수 있습니다. 다만 해당 수치는 Microsoft 자체 비교 결과입니다.
Nvidia의 경쟁 범위가 칩에서 시스템으로 확대
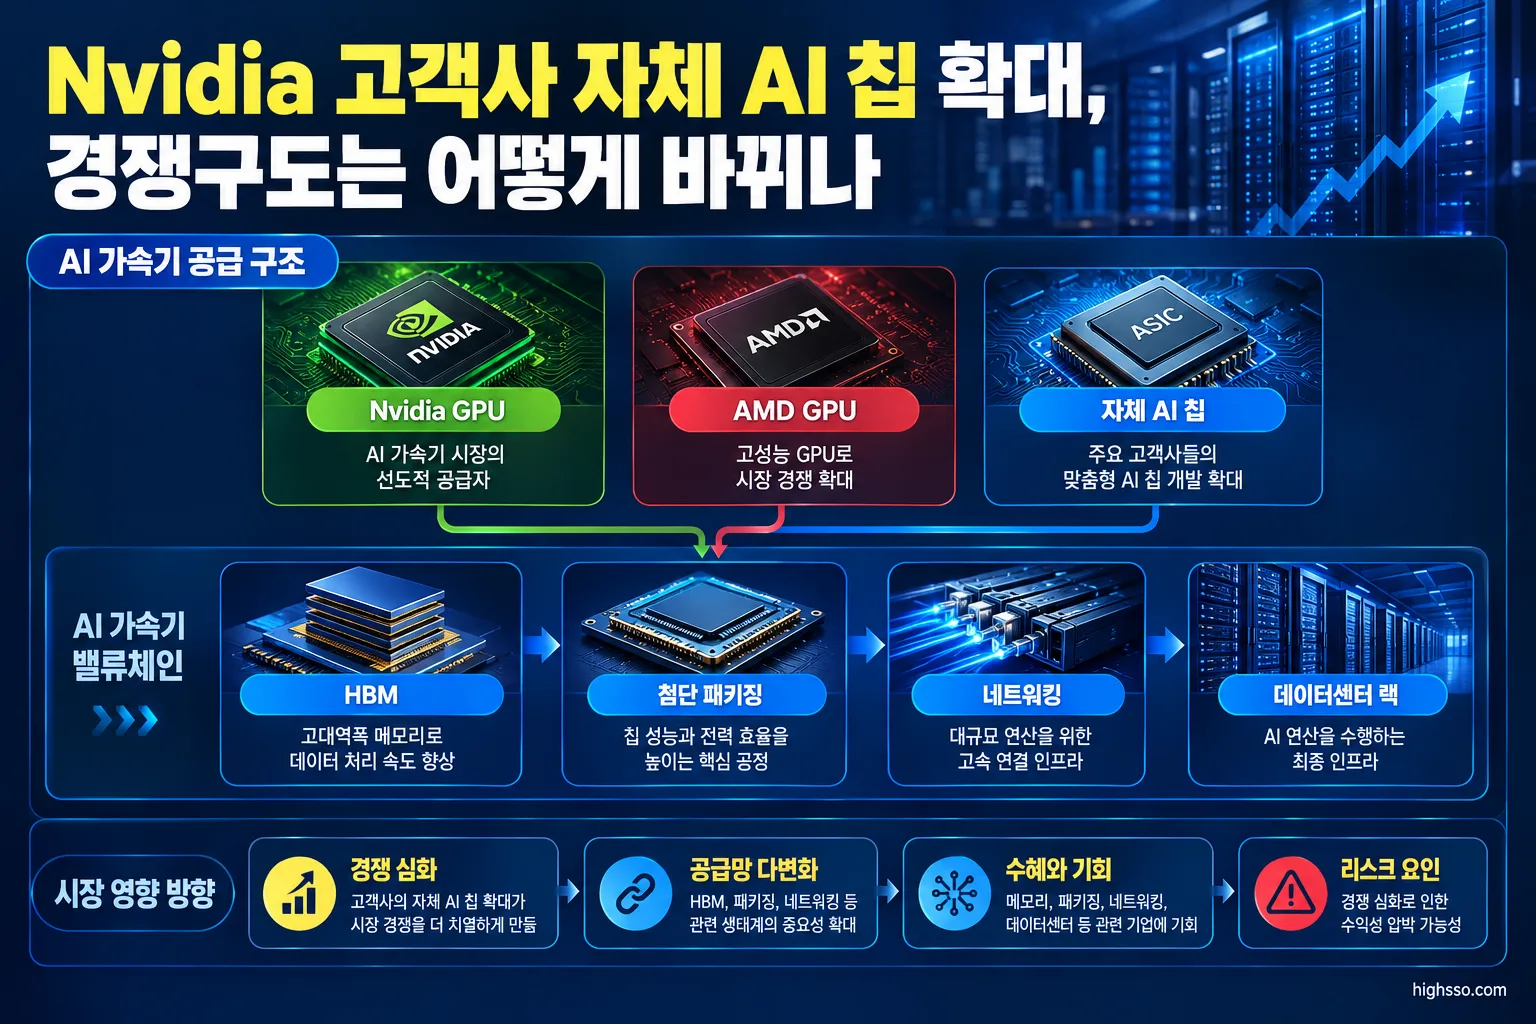
자체 AI 칩이 확산되면 Nvidia가 차지하던 AI 가속기 지출의 일부가 고객사의 내부 설계, TSMC 제조, HBM, 첨단 패키징, 네트워킹 비용으로 분산될 수 있습니다. 특히 반복적인 추론 수요에서 대형 고객이 자체 칩을 사용하면 Nvidia의 판매량, 가격 결정력, 총이익률에 중장기적인 압박 요인이 될 가능성이 있습니다.
그러나 현재 자료만으로 Nvidia GPU 수요가 즉시 감소한다고 단정하기는 어렵습니다. Microsoft는 Maia를 확대하면서도 Nvidia와 AMD의 최신 칩을 계속 활용한다고 밝혔습니다. 자체 칩 개발에는 컴파일러, 커널 최적화, 소프트웨어 생태계, 공급망 확보, 검증과 장애 대응 역량이 필요하기 때문입니다.
따라서 확인되는 방향은 ‘Nvidia의 전면 이탈’보다는 학습·추론·모델별로 Nvidia GPU, AMD GPU, 자체 ASIC을 조합하는 이기종 인프라의 확대입니다.
관련 산업·종목
Nvidia: GPU 단품에서 AI 팩토리 플랫폼으로
Nvidia는 자체 칩을 개발하는 고객을 단순 경쟁자로만 상대하지 않고, 자사 시스템에 연결하는 협력 전략도 병행하고 있습니다. 2026년 8월 MediaTek과 NVLink Fusion 협력을 확대해 클라우드 사업자와 AI 기업이 맞춤형 XPU를 개발하고 이를 Nvidia의 NVLink 기반 랙 규모 AI 시스템에 통합할 수 있는 경로를 제시했습니다.
이는 Nvidia가 GPU만 판매하는 구조에서 CPU, 네트워킹, 소프트웨어, 랙 시스템을 포함한 통합 플랫폼으로 경쟁 범위를 넓히려는 움직임으로 해석할 수 있습니다. 자체 칩의 확산을 인정하면서도 시스템 연결성과 소프트웨어 지위를 유지하려는 방어 전략입니다.
Microsoft·Google·AWS·Meta: 비용과 공급망의 내부화
Microsoft의 Maia, Google의 TPU, AWS의 Trainium·Inferentia, Meta의 MTIA는 각 회사의 내부 서비스와 클라우드 상품에 연결돼 있습니다. 이는 대형 고객이 AI 인프라의 설계권과 경제성을 직접 관리하려는 흐름으로 볼 수 있습니다.
Meta는 Broadcom과 차세대 MTIA 여러 세대를 공동 개발하고, 초기 배치 규모를 1GW 이상으로 확대한다고 밝혔습니다. 이 사례는 커스텀 칩 전략이 설계 단계에 머물지 않고 패키징, 네트워킹, 랙 시스템 등 인프라 전반으로 확장되고 있음을 보여줍니다.
HBM·첨단 패키징·네트워킹
자체 ASIC이 늘어나더라도 AI 인프라에 필요한 HBM, 첨단 패키징, 고속 네트워킹, 기판, 전력·냉각 부품 수요가 함께 증가할 수 있습니다. 따라서 Nvidia GPU의 점유율 변화가 AI 반도체 부품 수요 전체의 감소를 의미하는 것은 아닙니다.
한국 투자자는 SK하이닉스와 삼성전자의 HBM 세대별 공급 경쟁력, 첨단 패키징 투자, TSMC와의 제조 경쟁, 고객별 커스텀 ASIC 채택 현황을 함께 확인할 필요가 있습니다. 다만 Broadcom, Marvell, TSMC 등 개별 기업의 실제 수주와 매출 기여는 각 기업의 공시로 확인해야 하며, 시장의 추정과 공식 계약을 구분해야 합니다.
AMD는 대형 고객의 이기종 조달 전략에서 Nvidia의 대체 공급업체가 될 수 있습니다. 반면 자체 ASIC 전환 속도가 빨라지면 범용 가속기 시장 전체의 성장률이 낮아질 가능성도 있어, AMD의 수혜 여부는 커스텀 칩 채택 속도와 함께 봐야 합니다.
투자자가 볼 핵심
- 자체 칩 발표와 실제 배치를 구분해야 합니다. Maia 300의 100만 개 이상 규모는 Reuters가 전한 잠재 계획이며, 확정 출하량이나 매출로 볼 수 없습니다.
- Nvidia GPU 구매가 실제로 줄어드는지 확인해야 합니다. 자체 ASIC의 배치 확대만으로 Nvidia 매출 감소를 단정하기보다, 대형 고객의 GPU 주문 증가율과 추론용 GPU 비중을 함께 봐야 합니다.
- 가치가 칩 설계업체에서 공급망으로 분산될 수 있습니다. 커스텀 ASIC 확산은 HBM, 패키징, 제조, 네트워킹 업체에 새로운 주문 기회를 만들 수 있지만, 기업별 수주와 매출 기여는 별도 확인이 필요합니다.
- Nvidia의 방어력은 생태계와 시스템 통합에 달려 있습니다. CUDA, 네트워킹, 랙 시스템, 외부 고객 기반을 유지하면서 맞춤형 XPU까지 자사 플랫폼에 연결할 수 있는지가 중요합니다.
앞으로 확인할 것
- Microsoft Maia 300이 2027년 실제로 어느 규모로 램프업되는지
- Azure 외부 고객이 Maia를 얼마나 사용하고, 클라우드 매출에 어떤 기여를 하는지
- Google TPU와 AWS Trainium의 실제 클라우드 사용량 및 상품 매출 기여
- Meta MTIA가 추천·광고 추론을 넘어 생성형 AI 추론으로 얼마나 확장되는지
- Nvidia의 데이터센터 매출, 총이익률, 대형 고객의 GPU 구매 증가율이 어떻게 변하는지
현재까지 확인되는 사실은 Nvidia의 AI 가속기 지배력이 즉시 무너진다는 것이 아닙니다. 다만 Microsoft, Google, AWS, Meta가 자체 칩을 통해 비용·공급·성능·마진의 일부를 내부화하면서, Nvidia가 고객사의 유일한 선택지에서 여러 AI 인프라 공급자 중 하나로 점진적으로 이동할 가능성은 확인해야 할 구조적 변화입니다.
함께 볼 미국주식정보
이번 이슈와 함께
마이크로소프트 Maia 300, 2027년 멀티기가와트 AI 인프라로 확대
도 참고해볼 수 있습니다.
출처 및 참고자료
이 글은 아래 공식 자료와 주요 보도를 바탕으로 작성했습니다.
- Microsoft Official Blog — Microsoft to expand Azure Maia system to multi-gigawatt deployments
- Microsoft Investor Relations — Microsoft Fiscal Year 2026 Third Quarter Earnings Conference Call
- Reuters — Microsoft plans huge deployment of its own AI chips, with an eye on saving costs
- Meta Newsroom — Expanding Meta’s Custom Silicon to Power Our AI Workloads
- Meta Newsroom — Meta Partners With Broadcom to Co-Develop Custom AI Silicon
- Google Cloud Blog — Ironwood TPUs and new Axion-based VMs for your AI workloads
- Google Cloud Blog — AI infrastructure at Next ’26
- AWS — Announcing Amazon EC2 Trn3 UltraServers for faster, lower-cost generative AI training
투자 유의사항
본 콘텐츠는 공개 자료를 바탕으로 작성한 정보 제공 목적의 글이며, 특정 종목의 매수·매도 추천이나 투자 자문이 아닙니다. 투자 판단과 책임은 본인에게 있으며, 실제 투자 전에는 공시, 기업 실적 및 시장 상황을 추가로 확인하시기 바랍니다.